Занятие 13. Обход в глубину
1. Количество вершин в данной компоненте связности
В прошлом занятии мы обсудили способы хранения графов. В этом занятии мы начнём изучать алгоритмы на графах. Договоримся, что мы рассматриваем исключительно неориентированные графы без петель и кратных рёбер.
Поставим следующую задачу. Дан граф, в котором выделена вершина s. Требуется найти все вершины, лежащие в одной компоненте связности с ней. Иными словами, нужно понять, до каких вершин можно добраться из s. Будем считать, что граф задан списками смежности:
#
#   2--0--6--7   1--9   5
#   |  |  |
#   3--4  8
#
n = 10  # количество вершин
adj_list = [[2, 4, 6],
            [9],
            [0, 3],
            [2, 4],
            [0, 3],
            [],
            [0, 7, 8],
            [6],
            [6],
            [1]]
s = 0
Наш алгоритм будет основан на рекурсии. Опишем его идею. Встанем в вершину s и посмотрим на всех её соседей. Посетим каждого такого соседа. Когда будем посещать соседа, посмотрим на его соседей, и так далее. Когда мы посещаем вершину, мы вызываем функцию dfs(v), передавая в качестве параметра v номер этой вершины. Эскиз кода таков:
def dfs(v):  # dfs is an acronym for "depth-first search"
    for w in adj_list[v]:  # переменная w пробегает всех соседей вершины v
        dfs(w)

dfs(s)
Давайте подумаем, почему этот код не работает. Сначала вызовется функция dfs(0). Внутри функции переменная w примет значение 2, и вызовется функция dfs(2). При просмотре соседей вершины 2 мы увидим соседа 0 и опять вызовем dfs(0). Мы вошли в вечную рекурсию. Функции dfs(0) и dfs(2) будут продолжать вызывать друг друга, создавая новые фреймы в стеке вызовов функций, пока не будет превышен лимит интерпретатора на глубину рекурсии. *очень много страшных слов*
Как же исправить это недоразумение? Надо как-то помечать вершины, в которых мы были, и не ходить ещё раз в уже посещённые вершины.
Давайте заведём массив visited размера n, по ячейке на каждую вершину. В ячейке visited[v] будет лежать значение False, если вершина v пока не была посещена алгоритмом, и True, если вершина v была посещена. При первом заходе в вершину v мы меняем значение visited[v] с False на True.
#
#   2--0--6--7   1--9   5
#   |  |  |
#   3--4  8
#
n = 10
adj_list = [[2, 4, 6],
            [9],
            [0, 3],
            [2, 4],
            [0, 3],
            [],
            [0, 7, 8],
            [6],
            [6],
            [1]]
s = 0

visited = [False] * n  # массив "посещена ли вершина?"

def dfs(v):
    visited[v] = True
    for w in adj_list[v]:
        if visited[w] == False:  # посещён ли текущий сосед?
            dfs(w)

dfs(s)
Теперь наш код работает. Посмотрите в визуализаторе, в каком порядке dfs() посещает вершины. Обратите также внимание на стек вызовов функций. Заметьте, что значения локальных переменных v, которые лежат в стеке вызовов, в точности соответствуют вершинам пути, по которому мы пришли в текущую вершину из стартовой вершины s. Это замечание нам потом пригодится.
Вспомним же, наконец, какую задачу мы решали. Мы хотели посчитать количество вершин, которые достижимы из v. Но это ровно те вершины, которые были посещены функцией dfs(). А у них в массиве visited стоит метка True. Ответ получаем моментально:
print(visited.count(True))
if visited[w] == False:
if not visited[w]:
not True == False
not False == True
2. Подсчет количества компонент связности
Теперь поставим перед собой другую задачу: подсчитать количество компонент связности в графе. Эта задача оказывается довольно лёгкой. Действительно, запустим dfs() от вершины с номером 0. Если в результате весь граф будет обойдён, т. е. окажется, что в массиве visited все элементы равны True, то это будет значить, что в графе имеется только одна компонента связности.Пусть, однако, это не так, и для некоторых вершин visited[v] == False. Выберем среди таких вершин произвольную и запустим dfs() уже от неё. Запущенный обход в глубину посетит все вершины второй компоненты связности.
Такие действия надо производить до тех пор, пока в массиве visited остаются значения False. На практике делают один проход по всем вершинам, и каждый раз от непосещённых вершин запускается новый обход в глубину.
visited = [False] * n
for v in range(n):
    if not visited[v]:
        dfs(v)
Лёгко добавить в этот код переменную, которая будет считать количество компонент связности. Проделайте это.
Оценим суммарное время работы программы, которая подсчитывает количество компонент связности. Оценку произведём в обозначениях «О-большое». При этом буквой V мы обозначаем количество вершин в графе, а буквой E — количество рёбер.
Функция dfs() вызывается один раз от каждой вершины. Таким образом, только на её вызов и на константные по времени действия в ней (вроде изменения ячейки visited[v]) тратится O(V) действий. Далее, в цикле по переменной w каждый сосед каждой вершины будет просмотрен ровно один раз. Рассмотрим, например, ребро (0, 2). Его наличие означает, что внутри вызова dfs(0) в цикле по соседям вершины 0 переменная w в какой-то момент примет значение 2. Аналогично, при вызове dfs(2) переменная w ровно один раз примет значение 0. Таким образом, эти операции вносят суммарный вклад 2E = O(E) в общее время работы программы. Других действий в программе нет, так что суммарная сложность алгоритма получается O(V + E).
3. Проверка наличия пути между двумя вершинами
Пусть теперь мы хотим научиться быстро отвечать на запросы вида «лежат ли вершины v и w в одной компоненте связности?». Чтобы отвечать на эти запросы, неплохо бы для каждой вершины запомнить номер её компоненты связности. Давайте для начала заведём переменную, которая будет считать количество компомент связности:num_components = 0
visited = [False] * n
for v in range(n):
if not visited[v]:
dfs(v)
num_components += 1
Теперь можно завести массив component, в которой для каждой вершины мы запишем номер её компоненты. Как это можно сделать? Заметим, что пока мы посещаем вершины одной и той же компоненты связности, значение переменной num_components не меняется. А при переходе к рассмотрению новой компоненты связности значение этой переменной увеличивается. Значит, значение переменной num_components в тот момент, когда мы вызывали функцию dfs(v), логично считать номером компоненты связности для вершины v. Давайте запоминать это значение в массиве component. Приведём окончательный код.
#
#   2--0--6--7   1--9   5
#   |  |  |
#   3--4  8
#
n = 10
adj_list = [[2, 4, 6],
            [9],
            [0, 3],
            [2, 4],
            [0, 3],
            [],
            [0, 7, 8],
            [6],
            [6],
            [1]]

visited = [False] * n
component = [-1] * n  # для каждой вершины храним номер её компоненты
num_components = 0

def dfs(v):
    component[v] = num_components
    visited[v] = True
    for w in adj_list[v]:
        if visited[w] == False:
            dfs(w)

visited = [False] * n
for v in range(n):
    if not visited[v]:
        dfs(v)
        num_components += 1
Теперь представим, что нам дают номера двух вершин v и w, и спрашивают, есть ли путь между ними. Мы проверяем, равны ли значения component[v] и component[w]. Если они равны, то вершины v и w лежат в одной компоненте связности, и между ними существует путь. В противном случае такого пути нет.
В задаче, которую мы научились решать, есть две фазы: фаза подготовки (фаза предподсчёта) и фаза ответов на запросы (фаза ответов на запросы в коде не представлена). Сложность задач, которые состоят из этих двух фаз, принято оценивать отдельно по каждой фазе. В нашем случае время предподсчёта составляет O(V + E), а время ответа на запрос составляет O(1) (оно никак не зависит от размера графа).
4. Обход в глубину на неявных графах
До сих пор мы предполагали, что граф хранится в списке смежности, а вершины графа занумерованы числами 0, 1, 2 и т. д. На практике графы могут храниться по-другому, и у вершин могут быть не номера, а названия. Наконец, граф может не храниться вовсе. Рассмотрим лабиринт, нарисованный на клетчатой бумаге. Например, чёрные клетки могут означать наличие пространства в лабиринте, а белые — его отсутствие (стены).
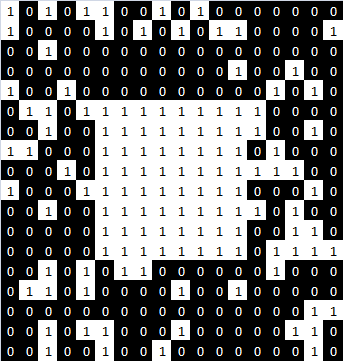
Пусть мы хотим рассматривать этот лабиринт как граф. Вершинами будут чёрные клетки (пространство), а две клетки-вершины соединены ребром тогда, когда они соединены по стороне. Тогда каждая вершина естественно обозначается не одним номером, а парой чисел — координатами клетки.
На таком графе можно запустить обход в глубину, который может искать путь между двумя клетками. В частности, с помощью обхода в глубину можно найти выход из лабиринта. При этом не нужно явно строить граф, записывая все рёбра между вершинами в списки смежности. Для обхода в глубину достаточно уметь по вершине получать список её соседей.
Пусть мы стоим в клетке с координатами (x, y). Соседями данной клетки являются клетки (x - 1, y), (x, y - 1), (x, y + 1) и (x + 1, y), если только получившиеся координаты неотрицательны.
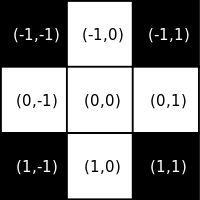
Покажем эскиз кода, который позволит элегантно перебрать всех соседей клетки (x, y) в языке Питон. При этом используется вариация множественного присваивания для счетчика цикла for.
def dfs(x, y):
    for dx, dy in [[-1, 0], [0, -1], [0, 1], [1, 0]]:
        dfs(x + dx, y + dy)
5. Вывод пути до вершины, поиск циклов
Мы уже умеем проверять, если ли путь между двумя вершинами. Пусть между вершинами s и t есть путь. Давайте научимся его выводить.Запустим dfs() от вершины s. Заметим, что в тот момент, когда мы дойдём до вершины t, в стеке вызовов функций будут последовательно лежать вызовы функции dfs() от всех вершин интересующего нас пути. Наш путь уже лежит где-то в памяти программы, но он лежит там, откуда вытащить его непросто. А нам надо легко его получать. Значит, придётся нам хранить его самостоятельно.
Для этого давайте заведём глобальный список path, в котором всегда будет поддерживаться путь от вершины s до той вершины, которую мы сейчас посещаем. При заходе в вершину мы кладём её номер в конец списка path. При выходе из вершины не забывайте свои номера. О номерах, оставленных другими вершинами, сообщайте машинисту.
path = []  # список для хранения текущего пути

def dfs(v):
    path.append(v)

    # всякие другие действия

    path.pop()  # удаляем последний элемент списка
Надеюсь, вы без труда допишете код, который будет выводить искомый путь в нужный момент.
6. Двудольные графы
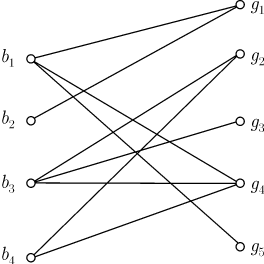
Наконец, последнее, о чём хочется поговорить в этом занятии — это о двудольных графах. Граф называется двудольным, если все его вершины можно разбить на две группы, при этом все рёбра должны обязательно идти из одной группы в другую, и запрещены рёбра, соединяющие две вершины из одной группы. На примере внизу двумя группами являются группа b и группа g.
Можно смотреть на двудольные графы как на графы, вершины которого раскрашены в два цвета. При этом раскраска является правильной, т. е. каждое ребро соединяет вершины разных цветов. На рисунке приведены несколько двудольных графов.
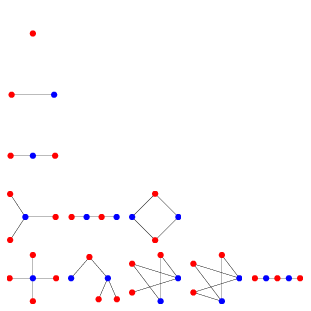
Некоторые графы нельзя правильно раскрасить в два цвета. Например, граф-треугольник нельзя раскрасить в два цвета: хотя бы одно ребро всегда будет соединять вершины одного цвета. На самом деле, можно доказать такую теорему.
Теорема. Граф является двудольным тогда и только тогда, когда в нём нет циклов нечётной длины.
Но давайте не будем обсуждать доказательство этой теоремы. Вместо этого научимся по графу понимать, можно ли его вершины правильно раскрасить в два цвета.
Я хочу дать лишь намёки на решение этой задачи. В решении стоит использовать обход в глубину, который будет ходить по вершинам и красить их. Вам понадобится глобальный массив color, в котором для каждой уже покрашенной вершины записывается её цвет. Наконец, стоит помнить текущий цвет, которым мы красим вершины. Лучше всего текущий цвет передавать в функцию dfs: тогда объявление функции будет выглядеть как dfs(v, curr_color). При вызове функции для соседа текущей вершины текущий цвет надо менять на противоположный.
7. Ограничение на глубину рекурсии в Питоне
В Питоне существует искуственное ограничение на количество вложенных рекурсивных вызовов, которое по умолчанию равно 1000 вызовам. Если ваша программа превысит это ограничение, то она будет остановлена с ошибкой выполнения. Чтобы изменить это ограничение, можно использовать функцию setrecursionlimit(max_depth) из модуля sys.# добавьте эти строки в начало программы from sys import setrecursionlimit setrecursionlimit(100000) # глубина стала 100 000 вызовов
Рекомендуем не думать над размером стека, который вам реально понадобится, и ставить этой функцией какое-нибудь большое число (106 или 109).